


KI-Recherche im Steuerrecht: Warum die Datenbasis entscheidet
KI wird in Steuerkanzleien längst zur Recherche eingesetzt. Laut einer Studie des sozialwissenschaftlichen Instituts Schad im Auftrag des Handelsblatts nutzen 91,6 % der Kanzleien bereits KI; zu den häufigsten Einsatzgebieten gehören Recherche und Mandantenkommunikation. Gerade bei der steuerrechtlichen Recherche zeigen sich jedoch Grenzen: Quellen werden übersehen, Rechtsstände verwechselt oder Fundstellen falsch angegeben. Warum passiert das – und was brauchen KI-Agenten, um im Steuerrecht verlässlicher zu recherchieren?
Vom Prompt zur agentischen Recherche
Mit der breiten Nutzung generativer KI ab 2023 arbeiteten viele Anwendungen zunächst vor allem mit dem Wissen des Sprachmodells und den Informationen, die Nutzende im Chat bereitstellten. Für viele Standardaufgaben funktionierte das gut. Sobald aber aktuelles oder spezifisches Wissen gefragt war, stießen die Modelle an Grenzen, da sie ausschließlich auf Basis ihres Trainingswissens antworten konnten. Was dort nicht enthalten war, existierte für sie nicht und externe Quellen wurden nötig.
Ein Lösungsansatz ist Retrieval-Augmented Generation (RAG): Das Sprachmodell erhält Zugriff auf Datenquellen und ist damit nicht mehr nur auf sein Trainingswissen beschränkt. Für steuerrechtliche Recherchen ist das grundsätzlich hilfreich, weil neben dem Modellwissen auch Fachquellen berücksichtigt werden können. Welche Quellen tatsächlich relevant sind, hängt im Steuerrecht allerdings oft von ihrem Rechtsstand und ihren Beziehungen zu anderen Quellen ab.
Agentische KI-Systeme können diese Recherche um weitere Schritte ergänzen. Sie verbinden ein Sprachmodell mit Werkzeugen wie Websuche oder Datenbankzugriff und können Zwischenergebnisse auswerten, bevor sie die nächste Aktion auswählen. Damit wurde genau das möglich, was mit einem reinen RAG-Ansatz noch nicht ging: Nach einer Suche kann der Agent anhand des Gefundenen entscheiden, eine weitere Suche durchzuführen. Das ist für steuerrechtliche Recherchen besonders hilfreich: Findet er beispielsweise eine vielversprechende, aber nicht mehr gültige Quelle, kann er in einem zweiten Schritt nach einer aktuellen Fassung oder Quelle suchen. Genau dafür braucht das System jedoch Informationen darüber, welche Quelle wann galt, welche Vorschrift geändert wurde oder welches Schreiben ein anderes ersetzt. Fehlen diese Zusammenhänge in der Datengrundlage, hilft auch eine mehrstufige Recherche nur begrenzt. Welche Folgen das haben kann, zeigt eine konkrete steuerrechtliche Recherche.
Warum steuerrechtliche Recherche für KI-Agenten anspruchsvoll ist
Bei steuerrechtlichen Recherchen müssen KI-Systeme mehr leisten als bei der Erstellung von Zusammenfassungen, Anschreiben oder E-Mails. Quellen müssen auffindbar, aktuell und im richtigen rechtlichen Zusammenhang eingeordnet sein. Fehler können deshalb fachlich schnell relevant werden: Relevante Quellen werden nicht gefunden, erfundene Quellen angegeben, die Rechtslage ist veraltet oder es fehlt das Verständnis grundlegender steuerrechtlicher Mechanismen.
Ein Beispiel zeigt, wie das in der Praxis aussehen kann. Auf die Frage nach der Anwendbarkeit des Urteils BFH VIII R 27/21 erklärte ein KI-Agent mit Zugriff auf die Internetsuche, das Aktenzeichen sei nicht als veröffentlichte BFH-Entscheidung nachweisbar. Stattdessen verweist er auf ein anderes Urteil und prüft dessen Anwendbarkeit. Das Problem: Das Urteil existiert jedoch.
Die Frage: „Ist BFH VIII R 27/21 noch anwendbar? Bitte prüfe Gesetzesänderungen, BMF-Schreiben und neuere Rechtsprechung mit Quellenlinks.“
Auszug aus der Antwort: „Wichtiger Hinweis: Mögliche Verwechslung des Aktenzeichens. Bevor ich inhaltlich antworten kann, muss ich auf ein grundlegendes Problem aufmerksam machen: Das Aktenzeichen „VIII R 27/21" existiert nicht nachweisbar als veröffentlichte BFH-Entscheidung.“
(Abfrage vom 19.07.2026. Wiederholte Abfragen können abweichend ausfallen.)
Ein KI-Agent kann mehrstufige Recherchen selbst planen und durchführen, greift dafür aber nur auf die Werkzeuge zurück, die ihm zur Verfügung stehen. Bei allgemeinen KI-Agenten kann dafür beispielsweise die offene Internetsuche zum Einsatz kommen. Dabei findet er verschiedenste Quellen: Veröffentlichungen von Gerichten und Finanzbehörden ebenso wie Fachbeiträge, Blogs oder Foren. Häufig findet er einschlägige Quellen gar nicht, da diese im Internet schlecht bis gar nicht auffindbar sind. Hinzu kommt: Viele Inhalte sind für die menschliche Nutzung aufbereitet. PDF-Format, Querverweise zum Anklicken, Fließtext für den Lesefluss. Für einen KI-Agenten sind das Hindernisse und keine Hilfen.
Was ihm darüber hinaus fehlt, sind die Angaben, aus denen sich die Ordnung der Quellen ergibt. Welche Fassung in welchem Zeitraum galt, welches Schreiben ein anderes ersetzt, welche Entscheidung überholt ist. Ohne diese Angaben kann er die Abhängigkeiten zwischen Normen und die Rangfolge der Quellen nicht verstehen.
Das Problem ist also nicht, dass KI-Agenten nicht recherchieren können, sondern dass sichergestellt werden muss, dass ihnen eine geeignete Datengrundlage zur Verfügung steht, die sie für die Recherche nutzen können.
Lösungsansätze
Es geht also darum, KI-Agenten steuerrechtliche Quellen in geeigneter Form zur Verfügung zu stellen. Im Markt lassen sich dabei drei Gruppen von Systemen unterscheiden.
Allgemeine KI-Agenten mit offener Internetsuche
Ihre Recherche hängt davon ab, welche Quellen öffentlich auffindbar und technisch zugänglich sind. Bei steuerrechtlichen Fragestellungen können deshalb relevante Fundstellen fehlen oder veraltete Inhalte in die Antwort einfließen.
Spezialisierte Anwendungen von Fachverlagen und Datenbankanbietern
Sie greifen auf einen lizenzierten und redaktionell gepflegten Bestand zu. Sie liefern erkennbar verlässlichere Ergebnisse und werden in der eigenen Anwendung betrieben.
Integrationen zwischen allgemeinen KI-Systemen und kuratierten Fachdaten
Über Schnittstellen können beispielsweise allgemeine KI-Anwendungen mit strukturierten steuerrechtlichen Datenquellen verbunden werden. Hier bleibt das Werkzeug, in dem gearbeitet wird, ein allgemeiner KI-Agent (wie beispielsweise Microsoft Copilot). Die Recherche greift aber auf gepflegte Quellen zu statt auf die offene Internetsuche.
Die Autoren arbeiten mit TaxGraph selbst an einer solchen Datengrundlage für allgemeine KI-Agenten. Die folgenden Beobachtungen beruhen daher teilweise auf Erfahrungen aus dieser Entwicklung. Für die technische Umsetzung kommen unterschiedliche Architekturen infrage. Zwei verbreitete Ansätze sind Vektor- und Graphdatenbanken.
Vektordatenbanken
Eine Vektordatenbank ordnet jeder Quelle eine Position in einem mehrdimensionalen Raum zu. Diese Position beschreibt den semantischen Wert, also sozusagen, was in der Quelle drinsteht. Sucht ein KI-Agent in einer solchen Datenbank, berechnet er für seine Anfrage ebenfalls eine Position. Herangezogen werden die Quellen, die dieser Position am nächsten liegen. Ausgewählt wird also, was inhaltlich gut passt.
Der Vorteil: Solche Datenbanken lassen sich relativ schnell aufbauen und sind bei unscharf formulierten oder explorativen Fragen stark.
Der Nachteil: Im Steuerrecht ist inhaltliche Ähnlichkeit oft kein Indikator für Relevanz. Ein BMF-Schreiben, das durch ein neueres Schreiben ersetzt wurde, kann inhaltlich gut klingen, hat für die Bearbeitung aber keine Relevanz.
Graphdatenbanken
Eine Graphdatenbank bildet zusätzlich Beziehungen zwischen Quellen ab. Sie speichert die Beziehungen zwischen den Quellen in sogenannten Kanten. Eine Quelle erhält also nicht eine Position im Vektorraum, sondern wird über ihre Verbindungen zu anderen Quellen definiert. So könnte eine Verbindung lauten: BMF-Schreiben vom 14.12.2015 (BStBl 2015 I S. 1091) ersetzt BMF-Schreiben vom 20.05.2003 (BStBl 2003 I S. 333).
Der Vorteil: Ein KI-Agent wählt damit nicht mehr nur aus, was inhaltlich gut klingt, sondern kann, wenn entsprechende Beziehungen im Graphen hinterlegt sind, auch erkennen, ob etwas überhaupt gilt. Er verfügt sozusagen über eine Landkarte des Steuerrechts.
Der Nachteil: Der Graph muss konzipiert, laufend gepflegt und aktuell gehalten werden. Die Qualität eines Graphen hängt vollständig an der Pflege seiner Kanten.
In der Praxis werden beide Ansätze deshalb häufig kombiniert: Der Graph für die Gültigkeit und Rangfolge, die Vektorsuche für den inhaltlichen Zugriff.
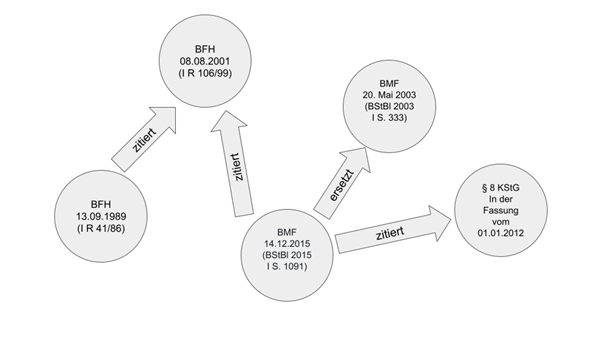
Schematische Darstellung der Beziehungslogik zwischen verschiedenen steuerrechtlichen Quellen.
Steuerrecht braucht eine geeignete Dateninfrastruktur
Wenn wir das Bild des Sprachmodells als Gehirn und der Tools als Werkzeuge wieder anwenden, wird deutlich: Ein mächtiges Gehirn ist theoretisch fähig, komplexere Probleme zu lösen, aber nur, wenn die richtigen Werkzeuge dafür zur Verfügung stehen. Es geht also nicht darum, mächtigere Sprachmodelle zu bauen, sondern darum, die richtigen Werkzeuge bereitzustellen, damit das Sprachmodell kompetent arbeiten kann.
Diese Werkzeuge müssen allerdings erst entstehen, denn viele Daten liegen bislang nicht in einer für KI-Systeme geeigneten Form vor. Ein Beispiel: Gesetzestexte sind oft nur in der aktuellen Fassung verfügbar. So sind z. B. historische Rechtsstände nicht flächendeckend als offene, strukturierte und maschinenlesbare Daten mit eindeutigem Geltungszeitraum verfügbar. Wer wissen will, welche Fassung einer Vorschrift in einem zurückliegenden Veranlagungszeitraum galt, muss sie aus den Änderungsgesetzen rekonstruieren. Artikel für Artikel, samt der Inkrafttretensregelungen, die oft gestaffelt und rückwirkend sind. Das erklärt beispielsweise, warum KI-Agenten oft den falschen Rechtsstand ausgeben: Sie finden die aktuelle Fassung, weil eben nur diese unmittelbar auffindbar ist.
Steuerrechtliche KI-Recherche: Darauf sollten Sie achten:
Datenquellen kennen: Arbeitet der Agent mit offener Internetsuche oder mit einem kuratierten Fachbestand? Davon hängt ab, wie belastbar seine Ergebnisse sind.
Fundstellen nachvollziehen: Achten Sie darauf, ob Quellen verlinkt und Fundstellen überprüfbar sind. Fordern Sie Quellenangaben ausdrücklich an, wenn das System sie nicht von selbst liefert. Prüfen Sie anschließend, ob die angegebene Quelle die Aussage tatsächlich stützt.
Rechtsstand prüfen: Ist der Rechtsstand in den Ergebnissen ersichtlich und passt er zum Veranlagungszeitraum des Falls? Gerade bei geänderten Vorschriften oder Verwaltungsanweisungen kann die aktuell auffindbare Fassung für einen zurückliegenden Zeitraum ungeeignet sein.
Originalquellen heranziehen: Öffnen Sie bei entscheidungserheblichen Aussagen die zugrunde liegenden Gesetzestexte, Verwaltungsanweisungen oder Entscheidungen. Die Zusammenfassung eines KI-Systems ersetzt nicht die Prüfung der Originalquelle.
Datenschutz und Berufsrecht beachten: Mandatsbezogene Daten gehören nur in Systeme, für die sie einen Auftragsverarbeitungsvertrag und eine Berufsgeheimnisträgervereinbarung haben. Ansonsten sind Sachverhalte zu anonymisieren.
Ergebnisse fachlich plausibilisieren: Prüfen Sie bei entscheidungserheblichen Aussagen, ob Fundstelle, Rechtsstand und die daraus gezogene Schlussfolgerung fachlich zusammenpassen. Eine KI-Recherche ersetzt nicht die Prüfung der maßgeblichen Originalquellen.
______________________
✍️ Selbst Lust darauf, Erfahrungen & Wissen zu teilen? Dann gerne hier eintragen:
IM BEITRAG ERWÄHNTES TOOL 


